
クローラーという言葉はご存知でしょうか?
ブログを書いている人やマーケティングに携わっている人であれば一度は耳したことがあると思います。
Googleなどの検索エンジンは、日々新しく更新される膨大な量の情報をクローラーというプログラムを使って読み込んでいます。クローラーはユーザーにとって利便性の良い検索エンジンにするために、Webページの品質をも評価をする機能が備わっています。そのため検索順位にも密接に関わっています。
本記事ではクローラーの仕組みや種類だけでなく、クローラー対策についても記載しております。ぜひ参考にしてみてください。

クローラーとは?
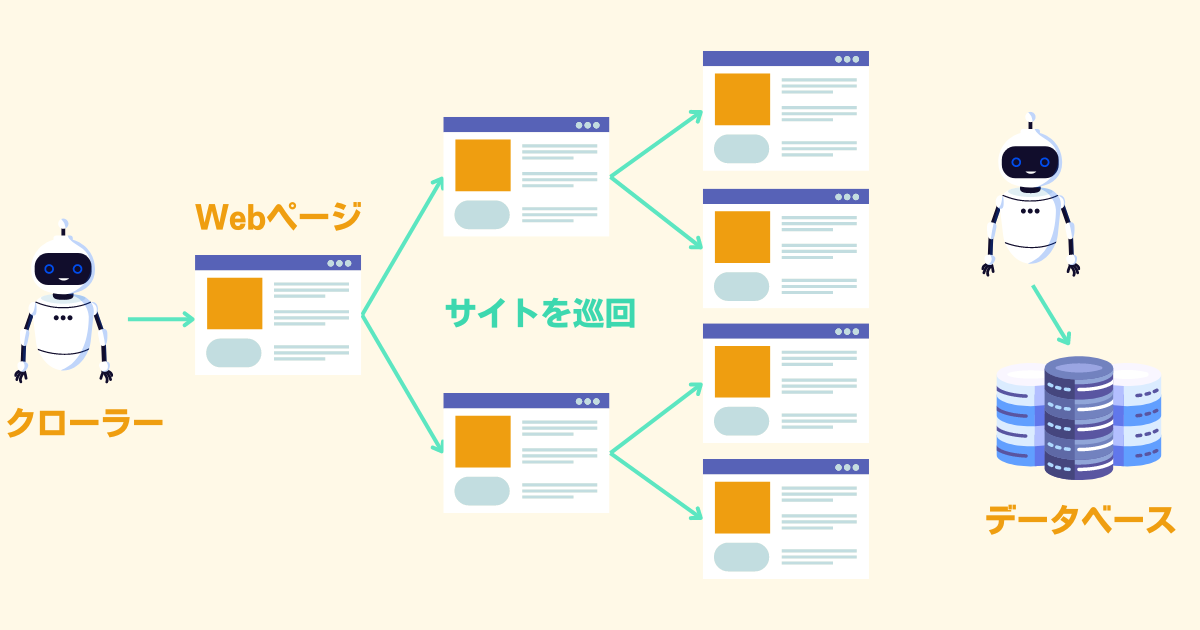
クローラーとは、Webサイトや画像、文章などインターネット上にある、ありとあらゆる情報を取得するプログラムを指します。取得したデータをもとに「検索データベース」を作成し、検索結果として表示できる状態にしてくれます。
クローラーはGoogleやMicrosoft Bingなど大型の検索エンジンで使用されており、毎日膨大な量の情報を巡回しています。インターネット上の情報を自動で取得するため「ロボット」「ボット(bot)」「スパイダー」などと呼ばれます。
クローラーの仕組み
クローラーは検索エンジンに搭載されている仕組みの一部です。検索エンジンは検索結果を表示させるまでに大きく4つのステップがあります。
- Webサイトのページ情報を発見・取得
- データベースへ登録
- アルゴリズムに従ってWebサイトページを評価・ランク付け
- ランク順に検索画面に表示
クローラーは上記ステップの中でも「Webサイトのページ情報を発見・取得」という役割を担っており、クローラーがサイトにやってきたときに初めて検索エンジンに存在を知らせることができます。
クローラーはどこから来るのか?
クローラは世界中のWebページを巡回しています。クローラーはリンク(別のページに飛ぶ仕組み)を辿って巡回しておりWebページから次のWebページへと移動しています。主に以下の場所からサイトにやってきます。
- 外部リンク
- インデックス登録をリクエストをしたURL
- サイトマップ
詳細は後ほど解説しますが、公開してすぐのページはクローラーもなかなかページを見つけられないため、発見しやすい状態にすることが重要です。そうすることで素早く検索結果に表示されるようになります。
クローラーの種類
クローラーにはいくつか種類があります。主にクローラーは検索エンジンに搭載されており主要な検索エンジンには、それぞれクローラーが存在します。
- Google:Google bot
- Yahoo!(海外版):Yahoo! Slurp
- bing:Bingbot
上記の他にもGoogle広告の品質をチェックする「AdsBot」やスマートフォン用Google botなど、用途によってさまざまなクローラーが存在します。
SEOにおけるクローラーの重要性
検索結果に表示されるためには、まずクローラーに発見してもらう必要があります。検索順位への直接的影響はないもの、クローラーに見つけられなければ順位をつけてもらうこともできません。
またクローラーが同じページを何度か巡回することで、検索エンジンに再評価され検索順位にも影響します。そのためクローラーが最適に巡回できる状態を構築することは非常に重要だといえます。
クローラーの取得対象となるファイル
クローラーが取得するファイルはHTMLのファイルだけでなく、さまざまな種類があります。HTTP/HTTPSプロトコル(Webサイトの住所のようなもの)によってサーバーと通信を取るため、クローラーは、HTTP/HTTPSプロトコルで取得できる情報をすべてクロールの対象としています。
具体的には以下のファイルを読み取ります。
・HTML
・画像
・動画 – サポートされている動画形式のいずれか。
・JavaScript
・CSS
・その他の XML – XML をベースとした RSS、KML などの形式を含まない XML ファイル
・JSON
・シンジケーション – RSS フィードまたは Atom フィード
・音声
・地理データ – KML または他の地理データ。
・その他のファイル形式 – ここに記載されていないその他のファイル形式。
・不明(失敗) – リクエストが失敗した場合、ファイル形式は不明となります。
引用元:クロールの統計情報レポート – Google Search Console ヘルプ
上記はGoogle botがクロールするファイルを記載しておりますが、他の検索エンジンにおいても、おおむね同様のファイルを読み取っています。
クローラーを最適に巡回させるための対策9選
検索結果に表示されるためには、まずクローラーに発見してもらう必要があると解説してきました。クローラーが発見しやすくかつ巡回しやすい状態のことをクローラビリティと呼び、検索結果に素早く表示させるためにはクローラビリティを向上させることが重要です。
クローラビリティを向上させるためには、いくつかの対策が必要になります。クローラーが最適に巡回できる状態を構築するために、以下の内容は最低限クリアしておきましょう。
- XMLサイトマップの設置
- URL表記名をシンプルにする
- 内部リンクの構造を最適にする
- 重複コンテンツをなくす
- 被リンク数を増やす
- 画像などのファイルサイズを縮小する
- ソフト404エラーを無くして回避する
- 不要なファイルのクローリングの拒否設定をする
- URL検査ツールを使う
それでは1つずつ解説していきます。
XMLサイトマップの設置
サイトマップにはXMLサイトマップとHTMLサイトマップの2種類存在します。HTMLサイトマップはユーザー向けの案内図のようなもの。XMLサイトマップとは、検索エンジンに自分のWebサイト内の構成や各コンテンツの関係性を示した住所録のようなものです。
XMLサイトマップがあることにより、サイト構造だけでなく、新しい記事やリライトの更新情報も素早くクローラーに伝えることができます。
URL表記をシンプルにする
URL表記名をシンプルにすることで、クロールされやすくなります。
あまりに長すぎるURLや不要なパラメーターが表示されているURLは、ユーザーにとってわかりにくいだけでなくクローラーも嫌います。Googleの公式ページでもURLについて以下のように述べています。
特に複数のパラメータを含む URL など、過度に複雑な URL は、サイト上の同じまたは同様のコンテンツを表す多数の URL を不必要に作成し、クロールの際に問題が生じることがあります。その結果、Google bot で必要以上に帯域幅を消費したり、サイトのすべてのコンテンツをインデックスに登録できないことがあります。
引用元:URL 構造を維持する – Google Search Consoleヘルプ
そのためなるべくシンプルな表記に変えたり、関連性が高いURLにすることでクローラーの巡回速度にも良い影響があります。
内部リンクの構造を最適にする
クローラーはWebページ内のリンク(内部リンク)を辿って他のページを発見します。そのため内部リンクを最適化させることでクローラーが発見しやすくなります。
具体的には以下のことを意識しながら内部リンクを設定してみてください。
- 関連性が高いページのリンクを貼る
- リンク先の内容がわかるようなアンカーテキストにする
- 共通ナビゲーションからリンクさせる
内部リンクを設置することで新規ページのインデックスを早めることができるため上記を意識しながら内部リンクを設定しましょう。
重複コンテンツをなくす
重複コンテンツとは、タイトル名やテキスト文章などページを構成している内容がほぼ同じページのことです。Googleは重複コンテンツについて以下のように述べています。
重複するコンテンツとは、ドメイン内または複数ドメインにまたがって存在する、他のコンテンツと完全に同じであるか非常によく似たコンテンツのブロックを指します。
※引用元:重複するコンテンツ – Google Search Console ヘルプ
自身のサイト内に同じような内容のページがあったり、他のサイトからテキストをコピーし似たようなページになっている場合は、重複コンテンツと見なされる可能性があります。重複コンテンツと見なされるとクロール巡回頻度が減るだけでなくペナルティの対象になることもあるので注意が必要です。
被リンク数を増やす
被リンクとは、ほかのWebサイトで自社のWebサイトへのリンクが設定されていることを指します。外部リンクとも呼ばれ、ほかのWebサイトに自社サイトのリンクが設定されていることで、そのWebサイトを経由して自社サイトがクロールされるため、通常よりもクロールされる機会が増えます。
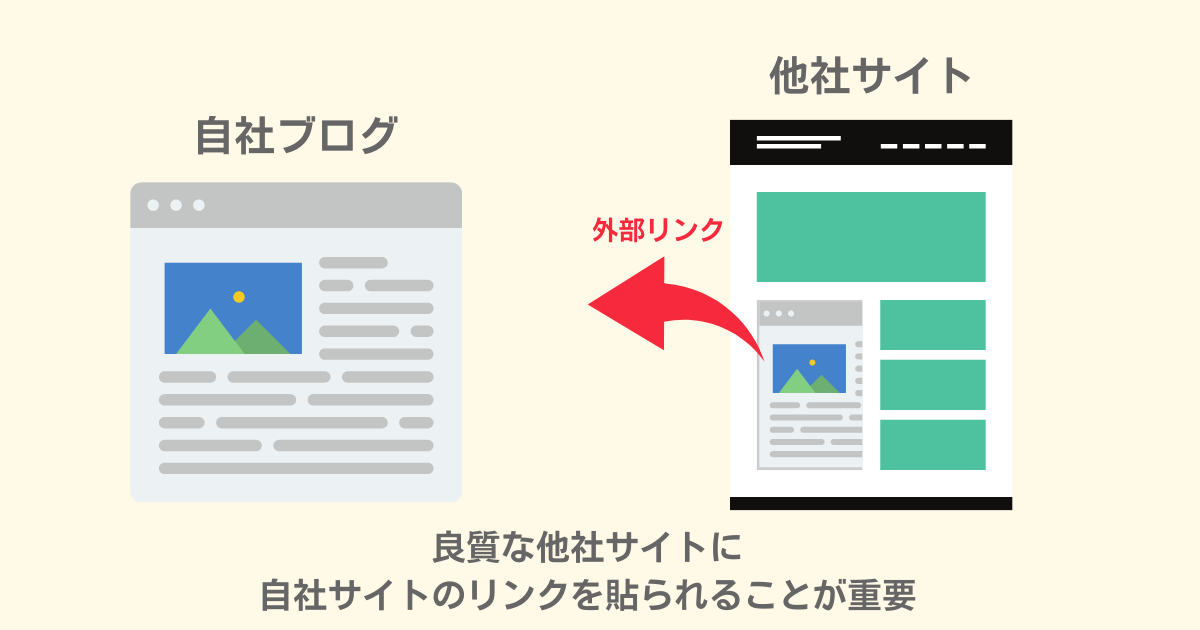
良質なコンテンツを増やし自然な被リンクを増やすことができれば、クローラビリティが向上しサイト全体の評価も高まります。
画像などのファイルサイズを縮小する
コンテンツに挿入する画像など、ページ内に存在するファイルサイズを縮小させることでクローラビリティが向上します。クローラーには一度に確認できる情報量が限られており、ファイルサイズが大きいと限られたページしかクロールされません。
また、ファイルサイズを縮小させることで表示速度が上がり、クローラーの読み込みが早くなるだけでなくユーザーの利便性も向上します。
画像やCSS、JavaScriptなどのファイルを圧縮し全体の表示速度を上げましょう。
ソフト404エラーを無くして回避する
ソフト404エラーとは、コンテンツが存在しないページにもかかわらずステータスコードが404になっていない状態をさします。簡単に言うと、そのURLにはコンテンツが存在しない(空白のページ)としても、存在していることになっているということです。
主な原因としては、コード記述が間違っていてクローラーが読み込めない、Googleの誤判定、文字数が少なくてコピー判定をさせた場合などさまざまです。
まずは、GoogleサーチコンソールなどのURL検査ツールを用いてどのページにエラーが出ているのか、どのような原因なのかを確認しましょう。
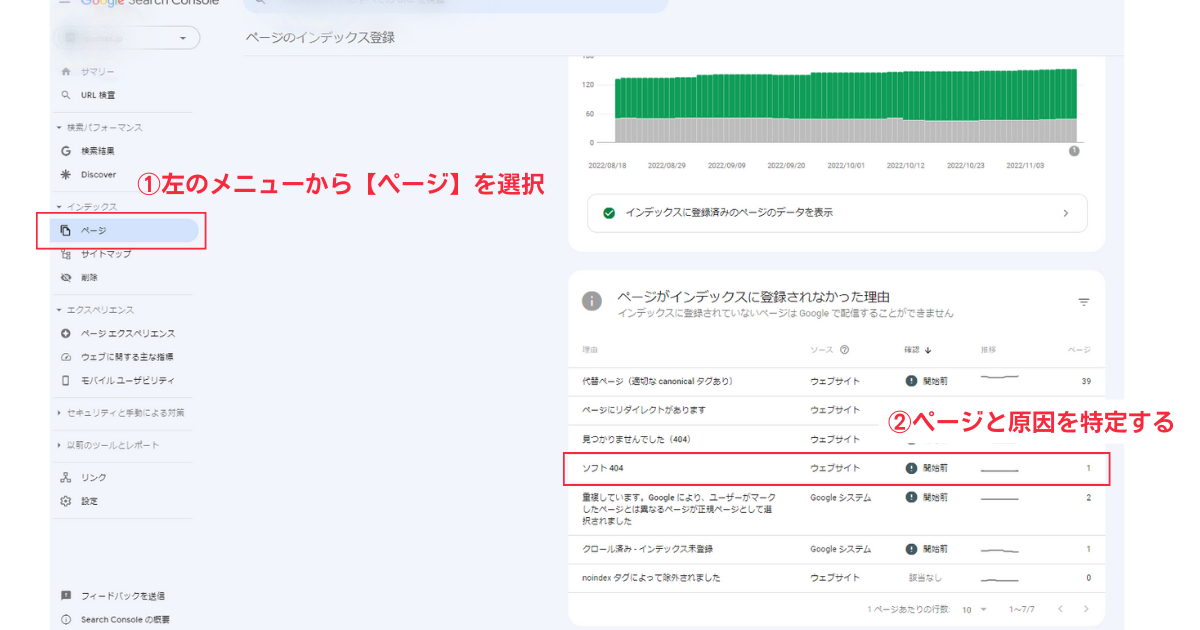
ソフト404エラーが多いサイトの場合、重要なページがインデックスされるまでに時間がかかったり、回遊頻度が下がってしまう恐れがあるため注意が必要です。
不要なファイルのクローリングの拒否設定をする
クローラビリティを向上させるために、不要なファイルのクローリングを拒否するという方法があります。たとえば補足的に添付したPDFファイルやPowerPointなど、クロールさせる重要度は低いがファイル容量は大きいものは積極的に拒否設定しましょう。
そうすることでクロールの速度が高まったり、他のページへクロール容量の分配をすることができます。
クロールを拒否する方法は、robots.txtというファイルを作成し以下を記述します。
User-Agent: *
Disallow: /test/sample.pdf
URL検査ツールを使う
GoogleサーチコンソールなどのURL検査ツールを使い、新規ページやリライトしたページのクロールをリクエストします。そうすることでクローラーが優先的に訪れてページ内を巡回させることができます。
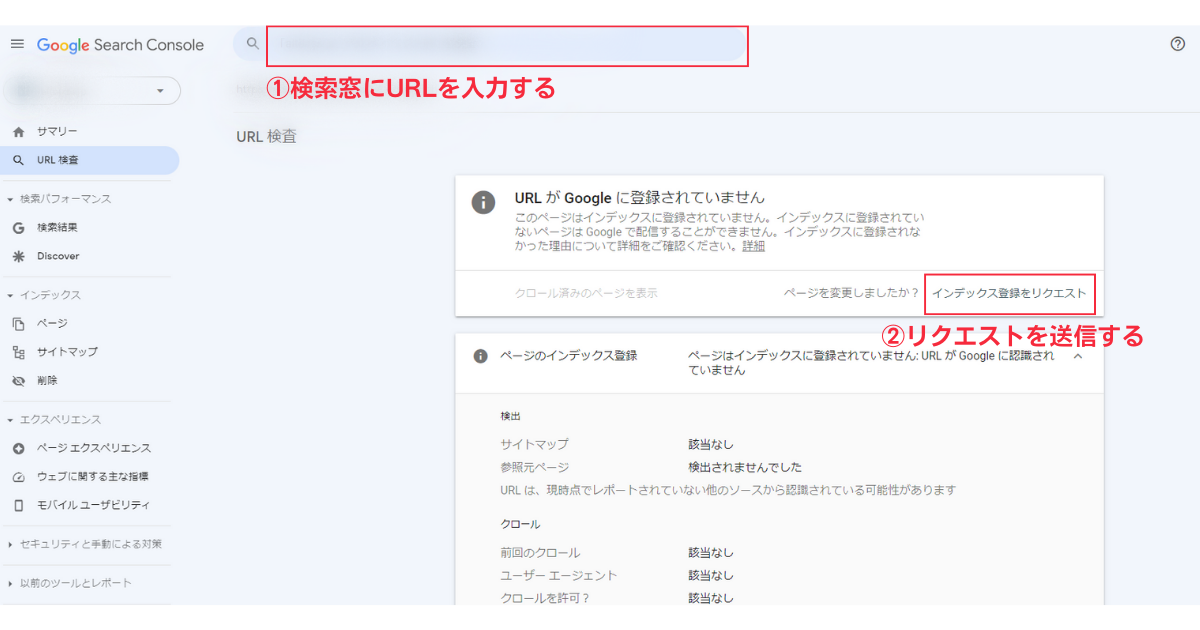
リクエストをしてもすぐには反映されず、多少のタイムラグがあります。登録されないからといって1日に何度も同じページのリクエストをしてしまうと「インデックス登録リクエスト」が使えなくなってしまう可能性もあるので注意が必要です。
最後に
今回はクローラーの仕組みや代表的な対策まで取り上げました。対策の方法は1つではなく、あらゆる角度からの対策が必要になります。以下クローラーを最適に巡回させるための対策を改めてまとめます。
- XMLサイトマップの設置
- URL表記名をシンプルにする
- 内部リンクの構造を最適にする
- 重複コンテンツをなくす
- 被リンク数を増やす
- 画像などのファイルサイズを縮小する
- ソフト404エラーを無くして回避する
- 不要なファイルのクローリングの拒否設定をする
- URL検査ツールを使う
クローラーへの理解は、Googleが考える良質なコンテンツを明らかにしSEOでも有利に評価を上げる一助となります。まずはユーザーにとって有益な情報か、良心的なページ構造になっているかを第一に考え、その上でクローラー対策を意識していただけたらと思います。